अवलोकन
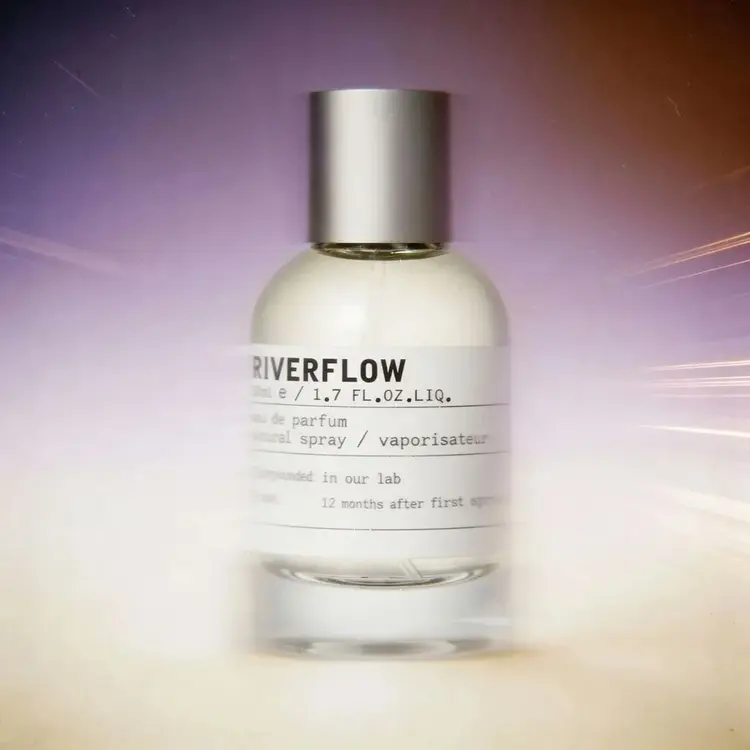
Riverflow 2.0 Pro एक text-to-image मॉडल है जो सटीकता के इर्द-गिर्द बनाया गया है: यह उत्पन्न छवियों के भीतर font rendering संभालता है, जिसे ज़्यादातर image models बहुत खराब तरीके से करते हैं। अगर आपने कभी ऐसा product label, social media graphic, या poster बनाने की कोशिश की है जिसमें visual के भीतर readable text चाहिए, तो आप garbled letters और smeared typography की झुंझलाहट जानते होंगे। Riverflow 2.0 Pro custom fonts (TTF, OTF, WOFF) को सीधे inputs के रूप में स्वीकार करके इसे हल करता है, ताकि आपकी छवि में टेक्स्ट उसी typeface से मेल खाए जिसे आपने वास्तव में निर्दिष्ट किया था। Picasso IA पर, आप इसे 4K resolution तक, aspect ratios की पूरी range में चला सकते हैं, vertical mobile formats से लेकर wide cinematic crops तक।
यह कैसे काम करता है
- scene, style, और कोई भी text जिसे आप छवि में दिखाना चाहते हैं, उसका वर्णन करते हुए अपनी generation instruction साधारण भाषा में लिखें।
- अगर output में विशिष्ट typography चाहिए, तो up to two font files अपलोड करें, और वे text strings दें जिन्हें प्रत्येक font का उपयोग करना चाहिए।
- composition को मार्गदर्शन देने के लिए वैकल्पिक रूप से reference images संलग्न करें, या मॉडल को केवल आपके text prompt से काम करने दें।
- अपना target resolution (1K, 2K, या 4K), aspect ratio, और output format (WebP या PNG) चुनें, और यदि आपको परिणाम को किसी अन्य design पर layer करना हो तो transparent background on करें।
- generate पर क्लिक करें। अंतिम image लौटाने से पहले output को refine करने के लिए मॉडल up to three internal reasoning iterations चलाता है।
अक्सर पूछे जाने वाले प्रश्न
क्या मुझे इसे उपयोग करने के लिए programming skills या technical knowledge की ज़रूरत है?
नहीं, बस Picasso IA पर Riverflow 2.0 Pro खोलें, अपनी इच्छित settings समायोजित करें, और generate पर क्लिक करें।
क्या इसे आज़माना मुफ़्त है?
हाँ, आप इसे परीक्षण करने के लिए Picasso IA पर बिना paid subscription के Riverflow 2.0 Pro चला सकते हैं। Credit usage आपके द्वारा चुने गए resolution और reasoning iterations की संख्या के अनुसार बदलती है।
क्या मैं उत्पन्न image के अंदर अपने own fonts का उपयोग कर सकता हूँ?
हाँ। TTF, OTF, WOFF, या WOFF2 format में up to two font files अपलोड करें और प्रत्येक को उस text string के साथ जोड़ें जिसे आप render करना चाहते हैं। मॉडल उस typography को अनुमान लगाने के बजाय सीधे output में शामिल करता है।
परिणाम पाने में कितना समय लगता है?
अधिकांश generations 1K resolution पर 30 seconds से कम में पूरी हो जाती हैं। उच्च resolutions और अधिक reasoning iterations समय बढ़ाते हैं, लेकिन 4K परिणाम आमतौर पर कुछ मिनटों के भीतर आ जाते हैं।
कौन से output formats समर्थित हैं?
आप परिणामों को WebP या PNG के रूप में डाउनलोड कर सकते हैं। जब आपको transparent background या print और client deliverables के लिए lossless quality चाहिए, तब PNG बेहतर विकल्प है।
मैं कई runs में अधिक consistent results कैसे प्राप्त कर सकता हूँ?
एक विशिष्ट, विस्तृत instruction लिखें और runs के बीच अपने resolution और aspect ratio settings को स्थिर रखें। वही reference images anchors के रूप में उपयोग करने से भी किसी project में visual continuity बनाए रखने में मदद मिलती है।
अगर परिणाम मेरे वर्णन से मेल नहीं खाता तो मुझे क्या करना चाहिए?
layout, color, और style के बारे में instruction को और विशिष्ट बनाइए, और model को self-correct करने के लिए अधिक steps देने हेतु max iterations setting बढ़ाइए। एक reference image जोड़ने से model को काम करने के लिए एक ठोस visual target मिलता है।