Visão geral
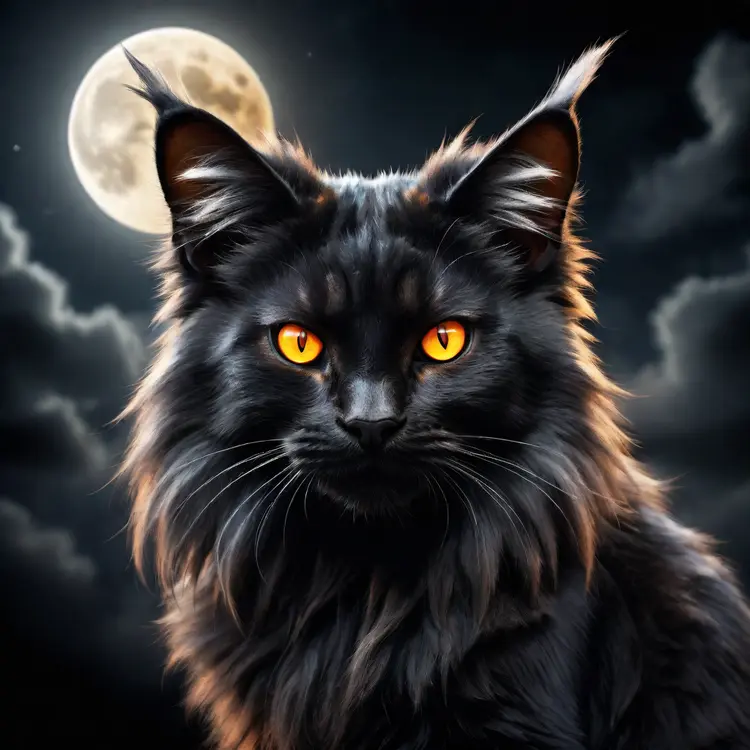
Open Dalle v1.1 é um modelo de texto para imagem criado para criadores que escrevem prompts detalhados e específicos e desejam que a saída realmente corresponda a eles. Ele lida com descrições complexas com múltiplos elementos com um nível de precisão semântica que poucos modelos abertos alcançam, rastreando e renderizando cada componente de um prompt em vez de aproximá-lo. Disponível no Picasso IA, ele suporta três fluxos de trabalho distintos: gerar imagens a partir de um prompt de texto, modificar uma foto existente usando o modo imagem para imagem e preencher seções mascaradas de uma imagem com inpainting. Se você está criando arte conceitual, refinando fotografia de produtos ou produzindo ilustrações do zero, este modelo é preciso o suficiente para trabalhar com ele em vez de contorná-lo.
Como funciona
- Escreva um prompt descrevendo a cena, o assunto, o estilo, as cores e o humor. Quanto mais específico você for, mais precisamente a saída corresponderá à sua intenção.
- Opcionalmente, carregue uma imagem de referência se desejar começar a partir de uma foto existente em vez de gerar do zero. Defina a força do prompt para controlar quanto o modelo se afasta do original.
- Desenhe ou carregue uma máscara se você estiver usando o modo inpainting. As áreas brancas são substituídas pelo modelo; as áreas pretas são preservadas exatamente como estão.
- Escolha um agendador e defina o número de etapas de inferência. Sessenta a setenta etapas produzem o detalhe mais nítido; trinta e cinco etapas dão resultados mais rápidos com um refinamento ligeiramente menor.
- Baixe seu resultado e, se necessário, ajuste a escala de orientação, seed ou prompt para iterar em direção à saída desejada.
Perguntas frequentes
Preciso de habilidades de programação ou conhecimento técnico para usar isso?
Não, basta abrir Open Dalle v1.1 no Picasso IA, ajustar as configurações que deseja e clicar em gerar.
É gratuito para experimentar?
Sim, você pode executar Open Dalle v1.1 gratuitamente. Verifique a página de preços para obter detalhes sobre limites de geração e planos disponíveis.
Quanto tempo leva para obter resultados?
A maioria das gerações termina em menos de 30 segundos. Usar 60 a 70 etapas de inferência dá os resultados mais nítidos; reduzir para 35 etapas reduz o tempo de geração notavelmente.
Quais formatos de saída são suportados?
O modelo produz arquivos de imagem padrão que você pode baixar imediatamente. A resolução padrão é 1024x1024 pixels, e você pode ajustar a largura e a altura de acordo com seu projeto.
Posso personalizar a qualidade ou o estilo da saída?
Sim. A escala de orientação controla o quão estritamente o modelo segue seu prompt em relação a interpretá-lo livremente. Trocar o agendador muda o caráter visual da saída, e aumentar ou diminuir as etapas de inferência equilibra o detalhe com a velocidade.
O que acontece se eu não estiver satisfeito com o resultado?
Mude uma variável de cada vez: refine o prompt, tente uma seed diferente ou ajuste a escala de orientação para cima ou para baixo. Pequenas alterações muitas vezes produzem resultados notavelmente diferentes, portanto, iterar geralmente é mais rápido do que começar do zero.
Onde posso usar as saídas?
Você pode usar as imagens em projetos pessoais, trabalhos do cliente ou aplicações comerciais.