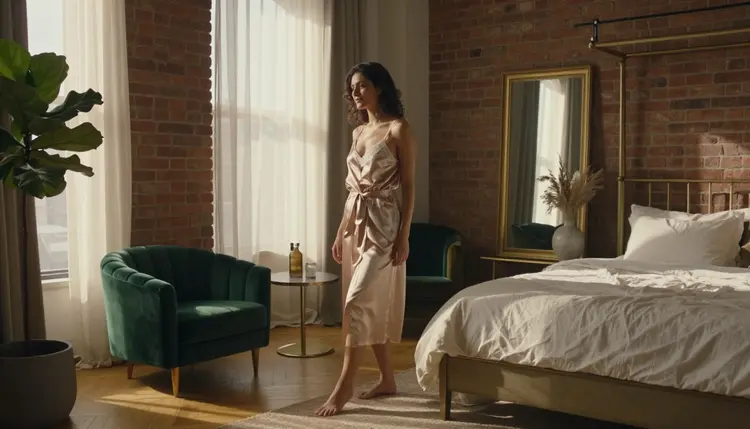
LTX 2.3 Pro genera un plano por cada solicitud, y no recuerda nada de la habitación que renderizó hace un minuto. Pide un dormitorio junto a una ventana en un prompt y otro dormitorio junto a una ventana en el siguiente, y el modelo te dará con gusto dos habitaciones distintas: un cabecero diferente, cortinas que nunca se describieron igual dos veces, una ventana que mira hacia otro lado. Una escena que se supone ocurre en un solo lugar solo se lee como un solo lugar si el espacio se planifica con el mismo cuidado que el personaje que está dentro de él.
Esta guía explica cómo escribir una descripción del espacio que se repita exactamente en cada toma, cómo fijar la luz y el ángulo de cámara para que nueve clips distintos se lean como nueve momentos del mismo lugar y no como nueve apartamentos diferentes, el proceso de cinco pasos para generar un vídeo NSFW cuyo escenario realmente se sostiene, y los errores que rompen la continuidad a mitad de una secuencia sin que nadie lo note, usando LTX 2.3 Pro, uno de solo seis modelos en Picasso IA confirmados para generar contenido para adultos directamente, sin que ningún filtro de seguridad se interponga. Cada personaje descrito en cada ejemplo de abajo es un adulto ficticio.
La mayoría de los consejos sobre consistencia en vídeo con IA se centran en el personaje: el mismo pelo, la misma cara, el mismo vestuario. El escenario recibe menos atención, y es justo por eso que se rompe primero. Una descripción de personaje suele escribirse una vez y copiarse a propósito en cada prompt. Una habitación, en cambio, se suele describir de pasada, con las pocas palabras que caben de forma natural en la frase de esa toma, y esas pocas palabras rara vez coinciden de un prompt a otro.
LTX 2.3 Pro trata cada generación como un render independiente. Nada del cabecero de latón ni de la ventana de la primera toma pasa a la segunda a menos que el prompt de esa segunda toma lo repita. Un espectador perdona con mucha más facilidad una pequeña diferencia en el vestuario que una habitación que cambia de forma a ojos vista, porque el espacio es lo fijo dentro de lo que se supone que ocurre la secuencia, no una variable que la historia pueda mover a su antojo.
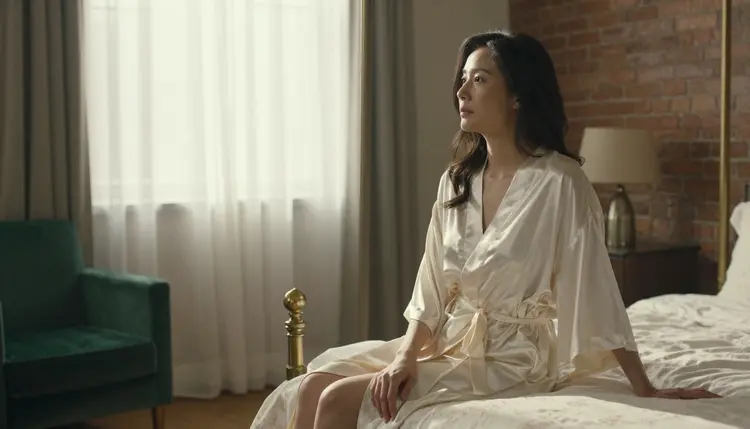
Una toma como esta solo funciona como primer fotograma de una secuencia, y no como una imagen suelta, si cada detalle visible en ella, el cabecero de latón, la ventana alta, la luz que cae sobre la ropa de cama, queda anotado antes de generar la segunda toma. De lo contrario, la siguiente toma en esa misma habitación supuesta arranca de una página en blanco, y el modelo rellena los huecos con lo que prefiera en esa generación.
La solución es la misma que funciona para un personaje: escribir la habitación una sola vez, en lenguaje llano, y pegar exactamente esa misma redacción en el prompt de cada toma donde aparezca el espacio. Una descripción del espacio que funciona suele necesitar cuatro tipos de detalle. La arquitectura, una ventana alta, un cabecero de latón, un suelo de roble. Los textiles, sábanas de lino color crema, una cortina translúcida, un sillón de terciopelo verde. El material de paredes y suelo, ladrillo visto en un lado, yeso claro en el otro. Y la fuente de luz, una sola ventana y nada más, para que cada toma pueda situarse en el tiempo por cómo entra la luz de esa ventana.
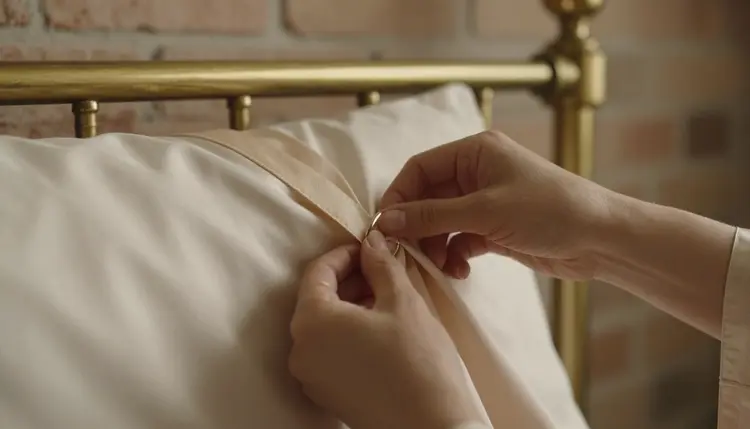
Una toma de detalle como esta sigue perteneciendo a la misma habitación aunque el encuadre casi no muestre nada de ella, porque el borde de la cama, la ropa de cama y la calidad de la luz de fondo coinciden con la redacción ya fijada en el paso anterior. Las tomas de detalle son, de hecho, el lugar más fácil para que el escenario se desvíe sin que nadie lo note, porque un encuadre cerrado oculta casi toda la habitación y una tela o un color de luz ligeramente distintos pasan desapercibidos a menos que esa misma descripción ancla esté también en el prompt de esa toma.
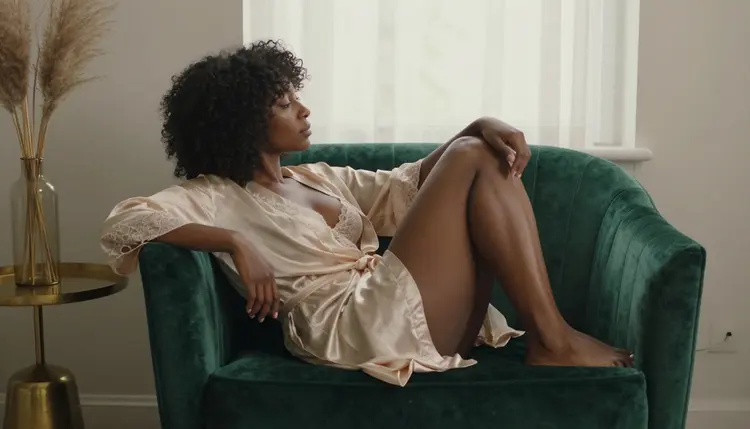
Pasar a una segunda pieza de mobiliario en la misma habitación, el sillón de terciopelo verde junto a esa misma ventana, es donde una descripción del espacio demuestra su valor. El sillón es información nueva, pero la ventana detrás no lo es: es la misma ventana alta de la primera toma, descrita de la misma forma, y eso es lo que le dice al espectador que ese sillón está en la misma habitación y no en un apartamento distinto al que la secuencia saltó sin avisar.
Convertir una habitación planificada en una secuencia que se sostiene sigue los mismos cinco pasos cada vez, antes de generar un solo clip en el toolkit.
- Escribe la Habitación Entera Una Sola Vez. Describe la arquitectura, el mobiliario, los materiales y la única fuente de luz en un solo párrafo, antes de escribir el prompt de ninguna toma, para que cada prompt posterior beba de la misma fuente en lugar de improvisar detalles nuevos cada vez.
- Pega Esa Descripción en el Prompt de Cada Toma. Reutiliza exactamente la misma redacción, no una paráfrasis, en cada toma que ocurra en esa habitación, porque hasta un cambio pequeño, lino color crema frente a lino blanco, se lee como una cama distinta para el modelo.
- Asigna una Sola Hora del Día, o Planifica el Cambio a Propósito. Decide si todas las tomas ocurren en la misma hora de luz o si la secuencia avanza de la mañana al atardecer, y escribe esa luz de forma explícita en cada toma en lugar de dejarlo al azar.
- Cambia el Ángulo, Nunca la Habitación. Deja que cada toma varíe en altura de cámara, distancia y encuadre, cerca, cenital, contrapicado, mientras las palabras de arquitectura y mobiliario permanecen intactas entre un prompt y otro.
- Genera Toda la Secuencia y Compara Cada Fotograma Uno al Lado del Otro. Renderiza cada toma en LTX 2.3 Pro y luego observa el cabecero, la ventana y la pared en todos los clips a la vez, porque una discrepancia invisible toma por toma suele saltar a la vista en cuanto dos fotogramas quedan uno junto al otro.
La mayoría de las secuencias necesitan regenerar una sola toma después de esa comparación, casi siempre porque un prompt dejó caer sin querer una palabra de material que los demás sí conservaron. Corregir ese único prompt y volver a generar solo esa toma es más rápido que reescribir toda la secuencia.
Una descripción del espacio por sí sola deja todavía dos variables libres: cómo está iluminado y desde dónde se filma, y ambas necesitan la misma disciplina que el mobiliario. La luz es la más fácil de fallar sin darse cuenta, porque un prompt que solo dice luz de ventana produce un resultado distinto casi en cada render. Nombrar la calidad concreta, luz cálida y baja de la mañana, luz plana y nublada, luz dorada tardía antes del atardecer, mantiene cada toma anclada al mismo momento del día, a menos que la secuencia avance deliberadamente a lo largo de varias horas.
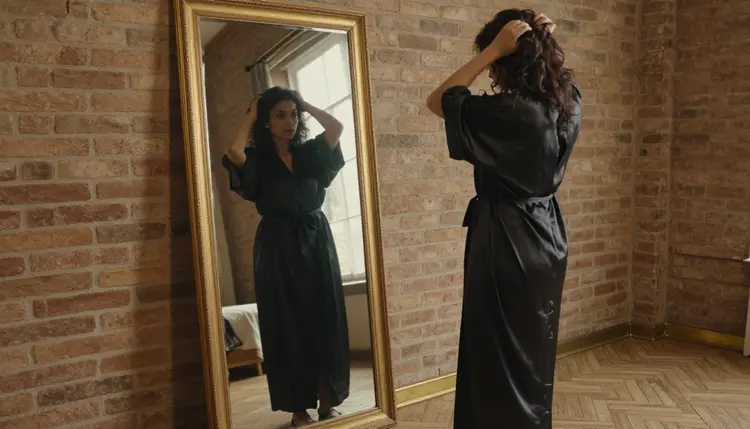
Una toma de espejo es una de las pruebas más exigentes para un escenario bien fijado, porque la habitación tiene que leerse correctamente dos veces en un mismo fotograma, una vez de forma directa y otra en el reflejo. Nombrar el espejo mismo, un espejo de cuerpo entero con marco de madera oscura, dentro de la descripción del espacio mantiene coherentes ambas versiones de la habitación entre sí y con el resto de tomas de la secuencia.
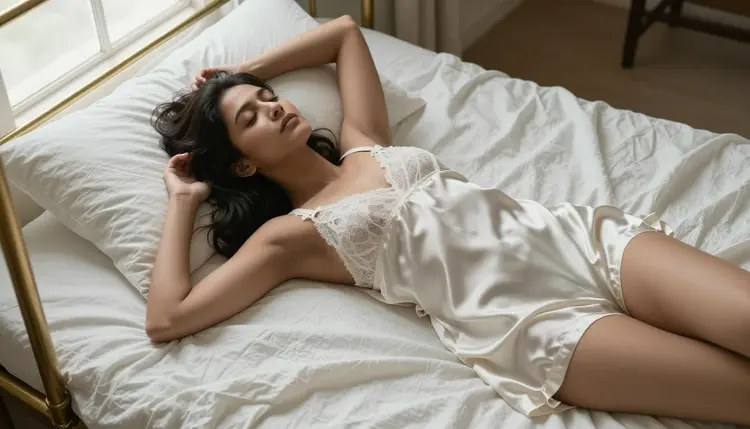
Un ángulo cenital cambia casi todo lo que hace legible una habitación, porque las paredes desaparecen del encuadre y solo quedan visibles la cama y el suelo. Por eso mismo la tela y la luz tienen que coincidir con lo anterior: con la arquitectura fuera de campo, el lino y la calidad de la luz son los dos únicos detalles que le quedan al espectador para saber que sigue siendo la misma cama de la toma anterior, y no una nueva generada desde cero.
Un puñado de hábitos explica la mayoría de las secuencias en las que la habitación deja de sentirse como un solo lugar a mitad de camino. Ampliar hacia una esquina nueva de la habitación sin anclarla es el más común. Una secuencia puede moverse sin problema de la cama a otra parte del mismo espacio, pero esa esquina nueva necesita el mismo vocabulario fijo que el resto, el mismo material de pared, el mismo suelo, la misma luz, o se leerá como un lugar completamente distinto que da la casualidad de compartir personaje.
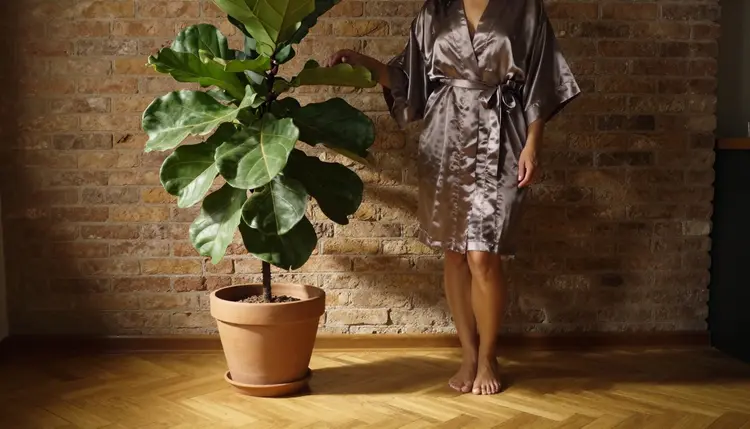
Una toma como esta, en contrapicado, encuadrada contra ladrillo visto con una planta en maceta dentro del plano, solo pertenece a la misma secuencia que las tomas del dormitorio si el ladrillo y esa planta ya formaban parte de la descripción del espacio desde el primer prompt. Introducidos sin previo aviso, en una toma que nunca antes mencionó ladrillo, se leen como un salto a otro apartamento y no como una vista más amplia del que ya se había establecido.
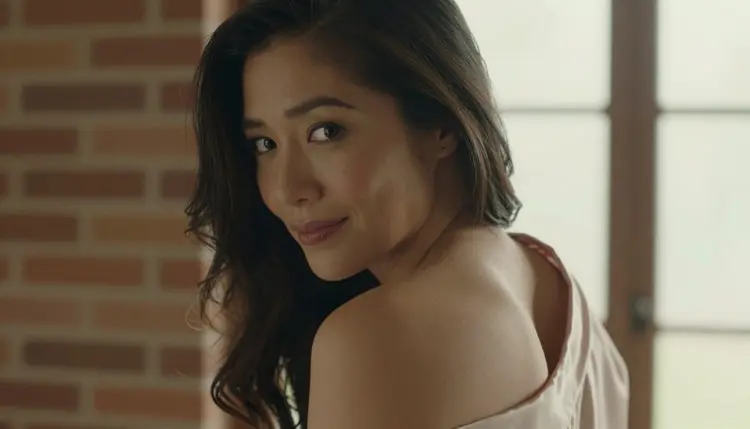
Apoyarse demasiado en primeros planos de retrato es el segundo hábito a vigilar. Un encuadre tan cerrado oculta casi toda la habitación, lo que lo convierte en una toma segura de generar pero en una mala base para construir toda una secuencia, porque el espectador nunca ve suficiente del espacio alrededor del sujeto como para juzgar si el escenario realmente se sostiene. Uno o dos retratos colocados entre tomas más abiertas funcionan bien. Una secuencia construida casi por completo con ellos no le da a la habitación suficiente espacio para demostrar que es consistente.
Picasso IA es una plataforma para mayores de 18 años, y una secuencia más larga no relaja esa regla solo porque se reparta en varias tomas en lugar de una. Cada personaje en cada toma de un escenario planificado debe leerse como un adulto ficticio, desde la primera toma de establecimiento hasta el último fotograma al atardecer. Las personas reales, las figuras públicas y cualquiera que pudiera leerse como menor de edad nunca son sujetos aceptables, y una línea de consentimiento afirmado escrita en el prompt no cambia eso.
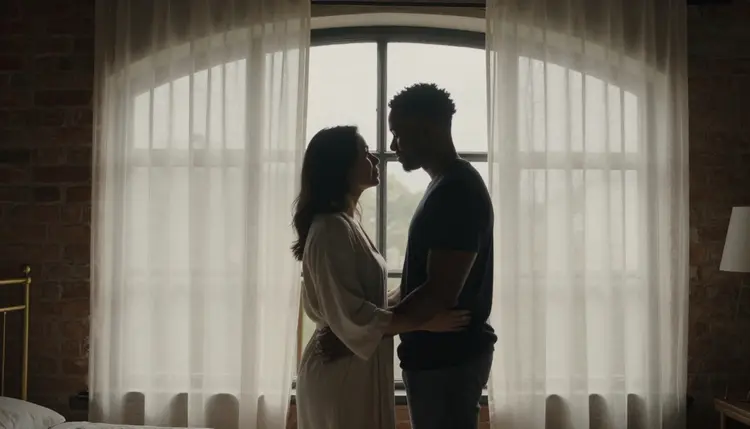
Una toma en silueta como esta, a contraluz frente a una ventana en arco al final de una secuencia, tiene que cumplir exactamente el mismo estándar que la primera toma del día. Planificar una escena más larga, o añadirle una segunda persona, nunca reduce lo que es o no un sujeto aceptable.
Las generaciones en Picasso IA se mantienen privadas por defecto, ya sea que un escenario se construya con una toma o con nueve. Nada de lo generado al probar una descripción del espacio, una configuración de luz o un ángulo de cámara se comparte, se publica ni se muestra a nadie más a menos que la propia cuenta decida compartirlo, y ese ajuste por defecto se mantiene en cada modelo usado para construir la secuencia, incluido LTX 2.3 Pro.
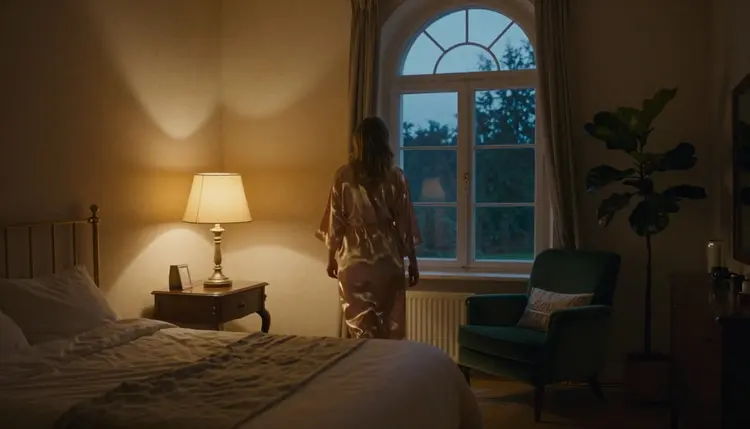
Una toma de cierre como esta, la misma habitación ahora iluminada por una lámpara al atardecer en vez de por el sol de la mañana, es exactamente para lo que sirve un escenario bien fijado: un solo lugar, seguido a lo largo de varias horas y varias tomas, con personajes adultos ficticios y nada del espacio dejado al azar. Ese es el resultado de anotar la habitación antes del primer prompt, y nunca se convierte en excusa para relajar ninguna de las dos reglas anteriores.
¿LTX 2.3 Pro recuerda automáticamente la habitación de una toma anterior?
No. LTX 2.3 Pro trata cada generación como un render independiente, así que nada de una habitación descrita en una toma pasa a la siguiente a menos que esa misma descripción también se escriba en el prompt siguiente.
¿Cuánta parte de la descripción del espacio hay que repetir en cada prompt?
Toda la parte fija: la arquitectura, el mobiliario, los materiales de pared y suelo, y la fuente de luz, escritos siempre de la misma forma, mientras que solo el ángulo de cámara y la acción en pantalla cambian de una toma a otra.
¿Puede el mismo escenario pasar de la mañana al atardecer a lo largo de una secuencia?
Sí, siempre que el cambio de luz se escriba a propósito en cada toma, luz de mañana, luz de mediodía, luz de atardecer, en lugar de dejarlo a que el modelo lo decida de forma distinta en cada render.
¿Cuál es la forma más rápida de comprobar si un escenario se mantuvo consistente entre tomas?
Genera toda la secuencia primero y luego mira cada fotograma uno junto al otro en lugar de uno por uno, porque una pequeña discrepancia en el cabecero, la ventana o la pared suele pasar desapercibida en un solo clip pero resulta evidente en cuanto dos tomas quedan una al lado de la otra.
¿Puede una secuencia mostrar más de una habitación?
Sí, pero cada habitación necesita su propia descripción fija, escrita una vez y reutilizada en cada toma que ocurra ahí, igual que con una sola habitación, en lugar de mezclar los detalles de dos espacios en un párrafo suelto.
¿Una toma de espejo necesita algo extra en la descripción del espacio?
Nombrar el espejo mismo, su forma y su marco, merece la pena añadirlo una vez que ya existe la descripción del espacio, porque una toma de espejo tiene que representar la habitación correctamente dos veces en un mismo fotograma, de forma directa y en el reflejo.
¿Es LTX 2.3 Pro el único modelo confirmado para una secuencia así?
Comparte ese estatus con Picasso Video, el otro modelo de Picasso IA confirmado para generar contenido para adultos directamente. LTX 2.3 Pro trabaja a partir de un prompt escrito para cada toma, mientras que Picasso Video anima una imagen de referencia ya existente, lo que puede convenir a una sola toma ya fijada como imagen fija.
¿Hay límites sobre quién puede aparecer en una secuencia con un escenario consistente?
Sí. Picasso IA es una plataforma para mayores de 18 años, y cada personaje en cada toma de una secuencia debe leerse como un adulto ficticio. Las personas reales, las figuras públicas y cualquiera que pudiera leerse como menor de edad nunca son sujetos aceptables, sin importar cuántas tomas abarque el escenario.
¿Una habitación más amplia con más mobiliario cuesta más créditos generar?
No. El coste en créditos se basa en la duración y la resolución elegidas para cada clip, no en lo detallada que sea la descripción del espacio, así que una descripción del escenario más completa no cuesta nada extra escribirla en el prompt.
¿Qué pasa si una toma de la secuencia no coincide con la habitación de las demás?
Regenera solo esa toma con la misma descripción del espacio pegada de nuevo, en lugar de reiniciar toda la secuencia, porque la discrepancia casi siempre es un detalle omitido o reformulado en ese único prompt y no un problema del plan completo.