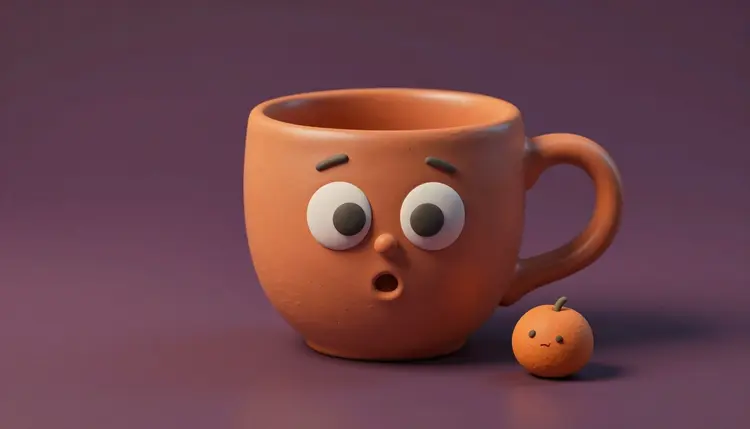सोमवार से शिकायत करता कॉफी मग, अपने पकने का समय बताता एवोकाडो, ब्रांड का परिचय देता मैस्कॉट: बोलती चीज़ें विज्ञापन की सबसे पुरानी तरकीबों में से हैं, और इनके लिए पहले एनिमेशन स्टूडियो चाहिए होता था। अब आप एक दोपहर में किरदार जनरेट कर सकते हैं, आवाज़ रिकॉर्ड या सिंथेसाइज़ कर सकते हैं और उससे चेहरा सिंक कर सकते हैं। एक चेतावनी: चीज़ें इंसानों से ज़्यादा मुश्किल होती हैं, और यह पेज बताता है कि कहाँ।
बोलती चीज़ वह काम करती है जो इंसानी प्रेज़ेंटर अक्सर नहीं कर पाता। वह एक सीधी और अच्छी वजह से याद रह जाती है: कोई उम्मीद नहीं करता कि स्टेपलर की अपनी राय होगी। यह समझाने वाले कंटेंट का झंझट भी हटा देती है: कैमरे के सामने किसी को बुलाने का इंतज़ाम नहीं, स्टूडियो किराए पर लेने की ज़रूरत नहीं। वीडियो में सिर्फ़ किरदार होता है, इसलिए देखने वाले का ध्यान सीधे आइडिया पर जाता है।
यह कुछ चुने हुए कामों के लिए अच्छा बैठता है। प्रोडक्ट पहले व्यक्ति में अपना परिचय दे सकता है, जिससे स्पेसिफिकेशन की सूची मज़ाक बन जाती है। फ़ूड ब्रांड में सामग्री खुद पिच कर सकती है। छोटा कारोबार अपनी दुकान के मैस्कॉट को हर पोस्ट में एक तय भूमिका दे सकता है। साझा सूत्र यह है: छोटी लाइन, साफ़ व्यक्तित्व और ऐसा दर्शक जो कुछ सेकंड मनोरंजन से खुश है।
Picasso IA में पूरी कड़ी एक ही जगह है: किरदार के लिए इमेज मॉडल, आवाज़ के लिए टेक्स्ट-टू-स्पीच, और मुँह के लिए अवतार या लिपसिंक मॉडल, सब टूलकिट के अंदर। नए अकाउंट को मुफ़्त क्रेडिट मिलते हैं, इसलिए कुछ खर्च करने से पहले आप जान सकते हैं कि आपका मग बोल पाता है या नहीं।
ऐसा कोई एक मॉडल नहीं है जो चीज़ों को बोलना सिखा दे। चार रूट हैं, और हर रूट कंट्रोल और मुँह की भरोसेमंदी के बीच सौदा करता है। कैटलॉग में लिपसिंक के 12, टेक्स्ट-टू-स्पीच के 24 और टेक्स्ट-टू-वीडियो के 121 मॉडल हैं, इसलिए सवाल यह नहीं कि क्या मौजूद है, बल्कि यह कि आपके बनाए किरदार के लिए कौन-सा रूट ठीक है।
| रूट | शुरू करने के मॉडल | किसके लिए सबसे अच्छा | किस पर ध्यान दें |
|---|
| फ़ोटो और ऑडियो | kling-avatar-v2, fabric-1.0, omni-human-1.5 | एक किरदार इमेज जो रिकॉर्ड की हुई लाइन बोले | इंसान के अलावा चेहरों पर मुँह की हरकत किरदार के हिसाब से बहुत बदलती है |
| मौजूदा क्लिप पर लिपसिंक | lipsync-2, lipsync-2-pro | ऐसी क्लिप जो आपने पहले से एनिमेट की है और सिर्फ़ मुँह को नए ऑडियो से मिलाना है | इंसानी चेहरों को ध्यान में रखकर बने हैं, इसलिए योजना बनाने से पहले अपनी चीज़ पर टेस्ट करें |
| इमेज से वीडियो, फिर वॉइसओवर | wan-2.6-i2v | ऐसे किरदार जो आवाज़ चलते समय हिलें और प्रतिक्रिया दें | मुँह शब्दों से नहीं जुड़ा होता, इसलिए आवाज़ स्क्रीन के बाहर हो तो बेहतर चलता है |
| स्थिर इमेज के आसपास कटअवे | कोई भी इमेज मॉडल और बी-रोल | लंबी स्क्रिप्ट जहाँ चेहरे को बस बीच-बीच में हिलना है | एडिटिंग ज़्यादा, चेहरे का समय कम |
पहले रूट से शुरू करें, क्योंकि उसमें सबसे कम चीज़ें लगती हैं: एक इमेज, एक ऑडियो फ़ाइल, एक जनरेशन। Kling Avatar v2 अपनी स्वीकार की जाने वाली चीज़ों में कार्टून किरदार, जानवर और स्टाइलाइज़्ड आर्ट गिनाता है, इसलिए मग के लिए वही पहला साफ़ टेस्ट है। Fabric 1.0 और Omni Human 1.5 वही दो इनपुट लेते हैं, और Omni Human 1.5 को 35 सेकंड से छोटा ऑडियो चाहिए। एक ही किरदार को दो मॉडल से गुज़ारें और बेहतर मुँह वाला रखें। बाकी मॉडलों की सूची लिपसिंक कलेक्शन में है।
आइडिया से तैयार क्लिप तक का यह सबसे छोटा रास्ता है। यह कुछ वाक्यों की स्क्रिप्ट मानकर चलता है, लंबे मोनोलॉग को नहीं।
- साफ़ चेहरे वाला किरदार जनरेट करें। nano-banana-2 या seedream-5-pro जैसा इमेज मॉडल इस्तेमाल करें। एक ही चीज़ माँगें, कैमरे की ओर मुँह किए, बड़ी आँखों और दिखते, हल्के खुले मुँह के साथ, सादे बैकग्राउंड पर।
- लाइन लिखें और आवाज़ बनाएँ। उसे चीज़ की अपनी आवाज़ में कुछ वाक्यों तक रखें। elevenlabs v3 या speech-2.8-hd जैसे टेक्स्ट-टू-स्पीच मॉडल से ऑडियो बनाएँ, और ऐसी आवाज़ चुनें जो व्यक्तित्व से मेल खाए, चीज़ से नहीं।
- अवतार मॉडल से चेहरा एनिमेट करें। kling-avatar-v2, fabric-1.0 या omni-human-1.5 खोलें, इमेज और ऑडियो जोड़ें, और मूड व हाव-भाव के लिए छोटा प्रॉम्प्ट डालें। एक बार जनरेट करें और आवाज़ के साथ देखें।
- कमज़ोर टेक ठीक करें। अगर मुँह मुश्किल से हिलता है, तो दूसरे मॉडल से, सोर्स इमेज में बड़े और ज़्यादा कार्टून जैसे मुँह से, या छोटी लाइन से दोबारा जनरेट करें। खराब टेक को लंबे प्रॉम्प्ट से बचाने की कोशिश न करें।
- ट्रिम करें और संदर्भ जोड़ें। क्लिप को सबसे अच्छे पलों के आसपास काटें, लाइनों के बीच बी-रोल या प्रोडक्ट शॉट डालें, और धीमी आवाज़ में बैकग्राउंड म्यूज़िक जोड़ें।
स्थिर इमेज को एनिमेट करने का आइडिया वही है जो AI बोलती फ़ोटो के पीछे है, बस यहाँ ऐसी चीज़ पर जिसकी नाक नहीं।
ज़्यादातर बोलती चीज़ें इमेज वाले चरण में ही फेल हो जाती हैं, एनिमेशन शुरू होने से पहले। लिपसिंक मॉडल को ऐसी चीज़ चाहिए जिसे वह मुँह की तरह पढ़ सके। दो बिंदुओं वाला और बिना मुँह का मग उसे एनिमेट करने को कुछ नहीं देता, इसलिए वह या तो चेहरा स्थिर छोड़ देता है या ऐसा मुँह गढ़ता है जो सतह पर फिसलता रहता है। मुँह जानबूझकर बनाएँ।
कुछ नियम लगभग हर किरदार पर लागू होते हैं। चेहरा चीज़ के सामने वाले हिस्से पर रखें और फ़्रेम में बड़ा रखें। उसे ऊपरी और निचले होंठ की साफ़ रेखा दें, या अंदर से गहरा खुला मुँह दें। चेहरे के आसपास ऐसी सजावट से बचें जो मुँह जैसी दिखे, जैसे हैंडल का मोड़ या कोई पत्ता।
सुझाव: किरदार की इमेज ऐसे जनरेट करें कि मुँह पहले से हल्का खुला हो, उस आकार में जो कार्टून किरदार किसी शब्द के बीच में बनाता है। अवतार मॉडल आपकी स्थिर इमेज से शुरू करते हैं, और खुले मुँह से शुरू होने पर उन्हें खोलने-बंद करने के लिए एक आकार मिलता है, गढ़ने के लिए नहीं।
स्टाइल का महत्व शरीर-रचना जितना ही है। कार्टून, क्ले या खिलौने जैसा किरदार किरदार की तरह पढ़ा जाता है, और दर्शक अकड़ी हुई हरकत माफ़ कर देते हैं क्योंकि वे उसकी उम्मीद करते हैं। इंसानी मुँह वाला फ़ोटोरियलिस्टिक फल असहज बीच की जगह पर आ जाता है, जहाँ हर छोटी गलती गलत लगती है। अगर आप कई वीडियो में वही किरदार चाहते हैं, तो एक रेफ़रेंस इमेज तय करें और उसे दोबारा इस्तेमाल करें, जैसा AI से एक जैसे किरदार में बताया गया है।
यह फ़ॉर्मेट छोटे, खास और थोड़े बेतुके लेखन को इनाम देता है। चीज़ को अपनी ज़िंदगी के बारे में ठीक एक बात पता होनी चाहिए और वह उसे आत्मविश्वास से कहे। मग जानता है कि उसे सुबह पकड़ा जाता है और तीन बजे भूलकर रख दिया जाता है। केला जानता है कि एक घंटे में वह भूरा हो जाएगा। यह छोटी-सी आत्म-जानकारी ही मज़ाक है और प्रोडक्ट का संदेश भी, एक ही लाइन में।
कान के लिए लिखें, छोटे वाक्यों में, और जनरेट करने से पहले हर वाक्य ज़ोर से बोलकर देखें। लंबे वाक्य आवाज़ की साँस फुला देते हैं और मुँह वाले मॉडल को गलती करने के लिए ज़्यादा शब्द देते हैं। अगर किसी बात को ज़्यादा समझाना है, तो एक लंबे टेक की जगह उसे दो क्लिप में बाँट दें। यही बात AI एक्सप्लेनर वीडियो पर भी लागू होती है, जहाँ किरदार ध्यान थामे रखने में मदद करता है जब तक बात पहुँच न जाए।
ब्रांड के इस्तेमाल में थोड़ी सावधानी चाहिए। आपका अपना मैस्कॉट, या आपका गढ़ा हुआ काल्पनिक किरदार ठीक है। किसी और कंपनी के प्रोडक्ट या मशहूर कार्टून जैसा दिखने वाला किरदार अच्छा विचार नहीं है। अगर चीज़ किसी ऐसी चीज़ की जगह खड़ी है जो आप बेचते हैं, तो इमेज को उस आइटम के बारे में ईमानदार रहना होगा, इसलिए बोलते मग को ऐसी खूबियाँ न दें जो असली मग में नहीं हैं। अगर किसी प्लेटफ़ॉर्म के AI कंटेंट या विज्ञापनों पर नियम हैं, तो पोस्ट करने से पहले उसकी मौजूदा ज़रूरतें देखें।
लिपसिंक इंसानी चेहरों को ध्यान में रखकर बना था, और चीज़ों के साथ यही दिखता है। इनके लिए तैयार रहें:
- असंगत मुँह: वही मॉडल एक किरदार का मुँह अच्छा हिला सकता है और दूसरे का लगभग स्थिर छोड़ सकता है, इसलिए सीरीज़ की योजना से पहले हर नए किरदार को टेस्ट करें।
- बहकते चेहरे: लंबी क्लिप में चीज़ की आँखें और सतह की बनावट फ़्रेमों के बीच बदल सकती हैं, जिसे इंसानी चेहरा रंगे हुए सिरेमिक से बेहतर सह लेता है।
- छोटी उपयोगी अवधि: मॉडल छोटी क्लिप के लिए बने हैं और कुछ ऑडियो पर सख़्त सीमा लगाते हैं, इसलिए लंबी स्क्रिप्ट को कई क्लिप में बदलकर जोड़ना पड़ता है।
- सपाट अभिनय: मूड प्रॉम्प्ट से तय होता है, अभिनेता को निर्देश देकर नहीं, और किरदार हँसने या आह भरने की बजाय चबाता हुआ लग सकता है।
- आवाज़ और किरदार का बेमेल: टेक्स्ट-टू-स्पीच आवाज़ में इंसानी साँसें और ठहराव होते हैं, और जब वे मुँह से मेल नहीं खाते तो हर हिस्सा अच्छा होने पर भी क्लिप अजीब लगती है।
इनमें से कुछ भी आइडिया को बेकार नहीं बनाता। यह उसे छोटा फ़ॉर्मेट बनाता है, जो एक मज़ाक, एक टिप या एक परिचय के लिए अच्छा है, और बारीक अभिनय पर टिकी किसी भी चीज़ के लिए कमज़ोर।
क्या AI किसी चीज़ को बोलना सिखा सकता है?
हाँ, सीमाओं के भीतर। आम रास्ता यह है कि चीज़ की चेहरे वाली इमेज जनरेट करें, टेक्स्ट-टू-स्पीच मॉडल से आवाज़ का ट्रैक बनाएँ, और दोनों को अवतार या लिपसिंक मॉडल में डालें जो मुँह एनिमेट करता है। नतीजा छोटी लाइनों और कार्टून जैसे किरदारों पर सबसे अच्छा चलता है। इंसानी मुँह वाली यथार्थवादी चीज़ें कम अनुमानित होती हैं, और पसंद का टेक मिलने से पहले कुछ बार दोबारा जनरेट करने की उम्मीद रखें।
बोलती चीज़ों के वीडियो के लिए कौन-से मॉडल सबसे अच्छे हैं?
उन अवतार-शैली मॉडलों से शुरू करें जो एक इमेज और एक ऑडियो फ़ाइल लेते हैं: kling-avatar-v2, fabric-1.0 और omni-human-1.5। Kling Avatar v2 अपने इनपुट में कार्टून किरदार, जानवर और स्टाइलाइज़्ड आर्ट साफ़ तौर पर गिनाता है, इसलिए यह समझदारी भरा पहला टेस्ट है। किरदार की इमेज के लिए nano-banana-2 और seedream-5-pro अच्छी शुरुआत हैं, और आवाज़ के लिए elevenlabs v3 और speech-2.8-hd। एक ही किरदार पर दो मॉडल आज़माएँ।
क्या लिपसिंक मॉडल इंसान के अलावा चेहरों पर काम करते हैं?
कभी-कभी। kling-avatar-v2 जैसे अवतार मॉडल किरदारों और जानवरों के लिए समर्थन बताते हैं, जबकि lipsync-2 और omni-human-1.5 जैसे मॉडल ज़्यादातर इंसानी चेहरों के आसपास बताए गए हैं, हालाँकि omni-human-1.5 चित्रित किरदारों का भी नाम लेता है। ईमानदार जवाब यह है कि नतीजा हर किरदार पर निर्भर करता है। साफ़ बने चेहरे और स्पष्ट मुँह वाला किरदार धुंधले चेहरे से कहीं ज़्यादा बार चलता है, इसलिए सीरीज़ तय करने से पहले एक क्लिप टेस्ट करें।
मग या फल को आवाज़ कैसे दूँ?
पहले लाइन लिखें, फिर टूलकिट में टेक्स्ट-टू-स्पीच मॉडल से उसे जनरेट करें। ऐसी आवाज़ चुनें जो व्यक्तित्व से मेल खाए: मग के लिए भारी और थकी आवाज़, नींबू के लिए चहकती आवाज़। लाइन को कुछ वाक्यों तक रखें, ऑडियो डाउनलोड करें और किरदार की इमेज के साथ अवतार मॉडल में जोड़ दें। आप अपनी आवाज़ भी रिकॉर्ड करके वही फ़ाइल इस्तेमाल कर सकते हैं, जो अक्सर सिंथेटिक आवाज़ से ज़्यादा स्वाभाविक लगती है।
बोलती चीज़ का वीडियो कितना लंबा हो सकता है?
यह मॉडल पर निर्भर है, और सीमाएँ असली हैं। Omni Human 1.5 को 35 सेकंड से छोटा ऑडियो चाहिए, और Kling Avatar v2 5MB तक की ऑडियो फ़ाइलें लेता है। दूसरे मॉडलों के अपने नियम हैं, इसलिए चुने हुए मॉडल की सेटिंग देखें। लंबी स्क्रिप्ट के लिए उसे कई छोटी क्लिप में बाँटें और जोड़ें, लाइनों के बीच दूसरे कोण या प्रोडक्ट शॉट पर जाते हुए।
क्या मैं कई वीडियो में वही मैस्कॉट रख सकता हूँ?
हाँ, अगर आप वही सोर्स इमेज दोबारा इस्तेमाल करें। किरदार एक बार जनरेट करें, पसंद का वर्शन चुनें और हर बार उसी फ़ाइल को शुरुआती इमेज बनाएँ। नई इमेज के लिए प्रॉम्प्ट बदलने से हर बार थोड़ा अलग किरदार बनता है। अगर मैस्कॉट नए पोज़ या दृश्यों में चाहिए, तो असली इमेज को रेफ़रेंस की तरह जोड़कर इमेज एडिटिंग मॉडल इस्तेमाल करें ताकि डिज़ाइन पहचानने लायक रहे।
मेरी चीज़ का मुँह मुश्किल से क्यों हिलता है?
आमतौर पर सोर्स इमेज मॉडल को मुँह की तरह पढ़ने लायक कुछ नहीं देती, या चेहरा बहुत छोटा या बहुत स्टाइलाइज़्ड होता है। इमेज को बड़े और साफ़ बने मुँह के साथ दोबारा जनरेट करें, बेहतर हो अगर हल्का खुला हो, और बैकग्राउंड सादा रखें। फिर भी न चले तो दूसरा अवतार मॉडल आज़माएँ, क्योंकि हर मॉडल चेहरों को अपने ढंग से पढ़ता है।
क्या मैं अपने ब्रांड का मैस्कॉट या किरदार इस्तेमाल कर सकता हूँ?
अगर वह आपका है, तो हाँ, और यह इस फ़ॉर्मेट के सबसे स्वाभाविक इस्तेमालों में से है। मैस्कॉट की इमेज को शुरुआती इमेज बनाकर अपलोड करें और अपना ऑडियो जोड़ें। पक्का करें कि किरदार आपका या काल्पनिक है: किसी और कंपनी का किरदार या किसी असली व्यक्ति की सूरत इस्तेमाल न करें। अगर क्लिप विज्ञापन है, तो जिस प्लेटफ़ॉर्म पर पोस्ट करेंगे उसकी मौजूदा ज़रूरतें देखें।
क्या मैं चीज़ के लिए किसी असली व्यक्ति की आवाज़ इस्तेमाल कर सकता हूँ?
सिर्फ़ अपनी आवाज़, या ऐसी आवाज़ जिसके इस्तेमाल की आपके पास साफ़ अनुमति हो। खुद को रिकॉर्ड करके फ़ाइल जोड़ना इंसानी स्पर्श पाने का सबसे आसान और सुरक्षित तरीका है। किसी सेलिब्रिटी, सहकर्मी या किसी और की नकल उनकी सहमति के बिना न करें, और किसी असली व्यक्ति के मुँह में शब्द डालने के लिए चीज़ का इस्तेमाल न करें। टेक्स्ट-टू-स्पीच मॉडल की सिंथेटिक आवाज़ इस समस्या से पूरी तरह बचा देती है।
बोलती चीज़ का वीडियो बनाने में कितना खर्च आता है?
जनरेशन क्रेडिट से चुकाए जाते हैं, और खर्च आपके चुने मॉडल और सेटिंग पर निर्भर करता है, इसलिए यहाँ लिखी कोई संख्या पुरानी पड़ जाएगी। बोलती चीज़ के वीडियो में कुछ चरण होते हैं: इमेज, आवाज़ का ट्रैक और एनिमेशन, और एनिमेशन वाला चरण आमतौर पर सबसे बड़ा होता है। नए अकाउंट मुफ़्त क्रेडिट से शुरू होते हैं, और मौजूदा प्लान प्राइसिंग पेज पर हैं।
अपनी मेज़ से कोई एक चीज़ चुनें और उसे एक लाइन दें। Picasso IA का टूलकिट खोलें, पहले चेहरा जनरेट करें और देखें कि क्या वह नमस्ते कह पाता है।