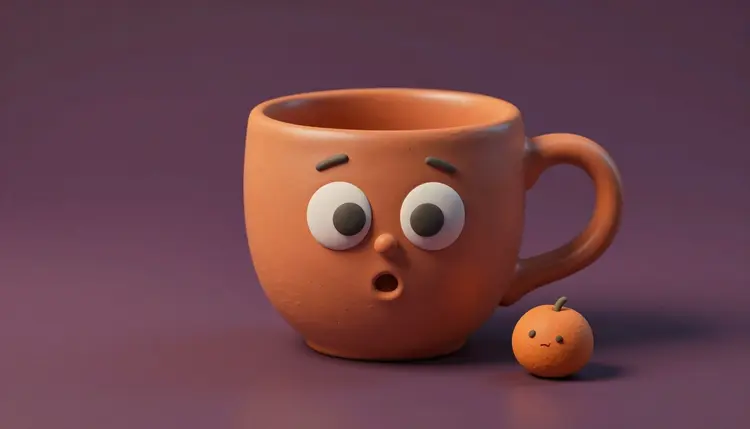Une tasse de café qui se plaint des lundis, un avocat qui explique quand il est mûr, une mascotte qui présente la marque: les objets parlants font partie des plus vieilles ficelles de la publicité, et il fallait autrefois un studio d'animation pour les faire. Aujourd'hui, vous pouvez générer le personnage, enregistrer ou synthétiser une voix et lui synchroniser un visage en un après-midi. Petit avertissement: les objets sont plus difficiles que les personnes, et cette page dit où.
Un objet parlant fait un travail qu'un présentateur humain ne peut souvent pas faire. On s'en souvient pour une raison idiote et bonne: personne ne s'attend à ce qu'une agrafeuse ait des opinions. Il supprime aussi la partie pénible du contenu explicatif: pas de personne à placer devant la caméra, pas de studio à louer. Le personnage est la seule chose dans la vidéo, donc l'attention du spectateur va à l'idée.
Il convient bien à un petit nombre d'usages. Un produit peut se présenter à la première personne, ce qui transforme une liste de caractéristiques en blague. Une marque alimentaire peut laisser l'ingrédient faire l'argumentaire. Une petite entreprise peut donner à la mascotte de la boutique un rôle fixe dans chaque publication. Le point commun: une réplique courte, une personnalité claire et un spectateur content de se divertir quelques secondes.
Sur Picasso IA, toute la chaîne est au même endroit: des modèles d'image pour le personnage, du texte vers la voix pour la parole et des modèles d'avatar ou de lipsync pour la bouche, le tout dans le toolkit. Les nouveaux comptes reçoivent des crédits gratuits, ce qui permet de savoir si votre tasse sait parler avant de dépenser quoi que ce soit.
Aucun modèle unique ne fait parler les objets. Il y a quatre routes, et chacune échange du contrôle contre de la fiabilité sur la bouche. Le catalogue compte 12 modèles de lipsync, 24 de texte vers la voix et 121 de texte vers vidéo: la question n'est donc pas ce qui existe, mais quelle route convient au personnage que vous avez dessiné.
| Route | Modèles pour commencer | Idéal pour | À surveiller |
|---|
| Photo plus audio | kling-avatar-v2, fabric-1.0, omni-human-1.5 | Une image de personnage qui dit une réplique enregistrée | Le mouvement de la bouche sur des visages non humains varie beaucoup d'un personnage à l'autre |
| Lipsync sur un clip existant | lipsync-2, lipsync-2-pro | Un clip déjà animé dont seule la bouche doit suivre un nouvel audio | Conçus autour de visages humains: testez sur votre objet avant de planifier quoi que ce soit |
| Image vers vidéo puis voix off | wan-2.6-i2v | Des personnages qui bougent et réagissent pendant qu'une voix joue | La bouche ne suit pas les mots, donc mieux vaut une voix hors champ |
| Plans de coupe autour d'une image fixe | N'importe quel modèle d'image plus du b-roll | Des scripts longs où le visage ne doit bouger que de temps en temps | Plus de montage, moins de visage à l'écran |
Commencez par la première route, car elle demande le moins d'éléments: une image, un fichier audio, une génération. Kling Avatar v2 cite les personnages de dessin animé, les animaux et l'art stylisé parmi ce qu'il accepte, ce qui en fait le premier test évident pour une tasse. Fabric 1.0 et Omni Human 1.5 prennent les deux mêmes entrées, et Omni Human 1.5 demande un audio de moins de 35 secondes. Passez le même personnage dans deux d'entre eux et gardez la meilleure bouche. La collection lipsync liste les autres.
Voici le chemin le plus court de l'idée au clip terminé. Il suppose un script de quelques phrases, pas un monologue.
- Générez le personnage avec un visage net. Utilisez un modèle d'image comme nano-banana-2 ou seedream-5-pro. Demandez un seul objet, face à la caméra, avec de grands yeux et une bouche visible et légèrement ouverte, sur fond uni.
- Écrivez la réplique et créez la voix. Gardez quelques phrases, dans la voix propre de l'objet. Générez l'audio avec un modèle de texte vers la voix comme elevenlabs v3 ou speech-2.8-hd, et choisissez une voix qui correspond à la personnalité, pas à l'objet.
- Animez le visage avec un modèle d'avatar. Ouvrez kling-avatar-v2, fabric-1.0 ou omni-human-1.5, joignez l'image et l'audio, et ajoutez un court prompt d'humeur et de geste. Générez une fois et regardez avec le son.
- Corrigez les prises faibles. Si la bouche bouge à peine, régénérez avec un autre modèle, une bouche plus grande et plus cartoon dans l'image source, ou une réplique plus courte. N'essayez pas de sauver une mauvaise prise avec un prompt plus long.
- Coupez et ajoutez du contexte. Découpez le clip autour des meilleurs moments, glissez du b-roll ou des plans du produit entre les répliques et ajoutez une musique de fond à bas volume.
L'idée d'animer une image fixe est celle des photos parlantes par IA, appliquée à quelque chose sans nez.
La plupart des objets parlants échouent à l'étape de l'image, avant toute animation. Un modèle de lipsync a besoin de quelque chose qu'il puisse lire comme une bouche. Une tasse avec deux points peints et sans bouche ne lui donne rien à animer: il laisse donc le visage immobile ou invente une bouche qui glisse sur la surface. Dessinez la bouche exprès.
Quelques règles valent pour presque tous les personnages. Placez le visage à l'avant de l'objet et gardez-le grand dans le cadre. Donnez-lui une ligne de lèvre supérieure et inférieure visible, ou une bouche ouverte à l'intérieur sombre. Évitez les décorations près du visage qui ressemblent à des bouches, comme la courbe d'une anse ou une feuille.
Conseil: générez l'image du personnage avec la bouche déjà légèrement ouverte, dans la forme qu'un personnage de dessin animé prendrait au milieu d'un mot. Les modèles d'avatar partent de votre image fixe, et une bouche qui commence ouverte leur donne une forme à ouvrir et fermer plutôt qu'une forme à inventer.
Le style compte autant que l'anatomie. Un personnage de dessin animé, de pâte à modeler ou de jouet se lit comme un personnage, et le spectateur pardonne un mouvement raide parce qu'il s'y attend. Un fruit photoréaliste avec une bouche humaine tombe dans un entre-deux gênant, où chaque petite erreur saute aux yeux. Si vous voulez le même personnage dans plusieurs vidéos, fixez une image de référence et réutilisez-la, l'approche expliquée dans personnages cohérents par IA.
Le format récompense l'écriture courte, précise et un peu absurde. L'objet doit savoir exactement une chose sur sa propre vie et la dire avec aplomb. Une tasse sait qu'on la prend le matin et qu'on la repose oubliée à trois heures. Une banane sait que dans une heure elle sera brune. Ce petit savoir sur soi, c'est la blague et le message produit en une seule phrase.
Écrivez pour l'oreille, en phrases courtes, et dites chacune à voix haute avant de générer. Les phrases longues essoufflent la voix et donnent au modèle de la bouche plus de mots à rater. Si un point demande plus d'explications, répartissez-le sur deux clips plutôt qu'une longue prise. La même idée vaut pour les vidéos explicatives par IA, où un personnage aide à tenir l'attention le temps qu'un argument passe.
L'usage de marque demande un peu de soin. Une mascotte qui est la vôtre, ou un personnage fictif que vous avez inventé, ne pose pas de problème. Un personnage qui ressemble au produit d'une autre entreprise ou à un dessin animé célèbre n'est pas une bonne idée. Si l'objet représente ce que vous vendez, l'image doit rester honnête sur l'article: ne donnez pas à une tasse parlante des caractéristiques que la vraie tasse n'a pas. Si une plateforme a des règles sur les contenus IA ou les publicités, vérifiez ses exigences actuelles avant de publier.
Le lipsync a été pensé autour de visages humains, et c'est avec les objets que cela se voit. Préparez-vous à ceci:
- Des bouches irrégulières: le même modèle peut bien animer la bouche d'un personnage et laisser celle d'un autre presque immobile, donc testez chaque nouveau personnage avant de planifier une série.
- Des visages qui dérivent: sur des clips plus longs, les yeux et la texture de surface de l'objet peuvent changer d'une image à l'autre, ce qu'un visage humain tolère mieux qu'une céramique peinte.
- Une durée utile courte: les modèles sont faits pour des clips brefs et certains imposent des limites strictes à l'audio, donc un long script doit devenir plusieurs clips montés ensemble.
- Un jeu plat: l'humeur se règle avec un prompt, pas avec une direction d'acteur, et le personnage peut avoir l'air de mâcher plutôt que de rire ou de soupirer.
- Une voix qui ne va pas au personnage: une voix de synthèse a des respirations et des pauses humaines, et quand elles ne collent pas à la bouche, le clip sonne faux même si chaque élément est bon.
Rien de cela ne rend l'idée inutilisable. Cela en fait un format court, bon pour une blague, un conseil ou une présentation, et faible dès que tout repose sur un jeu subtil.
L'IA peut-elle faire parler un objet?
Oui, dans certaines limites. La route habituelle consiste à générer une image de l'objet avec un visage, à créer une piste vocale avec un modèle de texte vers la voix, puis à envoyer les deux à un modèle d'avatar ou de lipsync qui anime la bouche. Le résultat marche mieux avec des répliques courtes et des personnages de style dessin. Les objets réalistes avec une bouche humaine sont moins prévisibles, et il faut s'attendre à régénérer plusieurs fois avant d'obtenir une prise qui vous plaît.
Quels modèles marchent le mieux pour les vidéos d'objets parlants?
Commencez par les modèles de type avatar qui prennent une image et un fichier audio: kling-avatar-v2, fabric-1.0 et omni-human-1.5. Kling Avatar v2 cite explicitement les personnages de dessin animé, les animaux et l'art stylisé parmi ses entrées, c'est donc un premier test raisonnable. Pour l'image du personnage, nano-banana-2 et seedream-5-pro sont de bons points de départ, et pour la voix, elevenlabs v3 et speech-2.8-hd. Essayez deux modèles sur le même personnage.
Les modèles de lipsync marchent-ils sur des visages non humains?
Parfois. Les modèles d'avatar comme kling-avatar-v2 décrivent une prise en charge des personnages et des animaux, tandis que des modèles comme lipsync-2 et omni-human-1.5 sont surtout décrits autour de visages humains, omni-human-1.5 citant aussi des personnages illustrés. La réponse honnête, c'est que le résultat dépend de chaque personnage. Un visage bien dessiné avec une bouche évidente marche bien plus souvent qu'un visage discret, donc testez un clip avant de vous engager dans une série.
Comment donner une voix à une tasse ou à un fruit?
Écrivez d'abord la réplique, puis générez-la avec un modèle de texte vers la voix dans le toolkit. Choisissez une voix qui va à la personnalité: une voix rauque et fatiguée pour une tasse, une voix vive pour un citron. Gardez la réplique à quelques phrases, téléchargez l'audio et joignez-le au modèle d'avatar à côté de l'image du personnage. Vous pouvez aussi enregistrer votre propre voix et utiliser ce fichier, qui sonne souvent plus naturel qu'une voix synthétique.
Combien de temps peut durer une vidéo d'objet parlant?
Cela dépend du modèle, et les limites sont réelles. Omni Human 1.5 demande un audio de moins de 35 secondes, et Kling Avatar v2 accepte des fichiers audio jusqu'à 5 Mo. D'autres modèles ont leurs propres règles, alors vérifiez les réglages du modèle choisi. Pour un script plus long, découpez-le en plusieurs clips courts et montez-les ensemble, en passant à un autre angle ou à un plan du produit entre les répliques.
Puis-je garder la même mascotte dans plusieurs vidéos?
Oui, si vous réutilisez la même image source. Générez le personnage une fois, choisissez la version qui vous plaît et utilisez ce fichier comme image de départ à chaque fois. Changer le prompt pour obtenir une nouvelle image crée à chaque fois un personnage un peu différent. Si vous avez besoin de la mascotte dans de nouvelles poses ou scènes, utilisez un modèle d'édition d'image avec l'original joint comme référence, pour que le dessin reste reconnaissable.
Pourquoi la bouche bouge-t-elle à peine sur mon objet?
En général, l'image source ne donne au modèle rien qu'il puisse lire comme une bouche, ou bien le visage est trop petit ou trop stylisé. Régénérez l'image avec une bouche plus grande et clairement dessinée, idéalement légèrement ouverte, sur fond uni. Si cela échoue encore, essayez un autre modèle d'avatar, car chacun lit les visages à sa façon. Un audio très faible ou très long peut aussi donner un mouvement mou, alors vérifiez l'audio.
Puis-je utiliser la mascotte ou le personnage de ma marque?
Si c'est le vôtre, oui, et c'est l'un des usages les plus naturels du format. Importez l'image de la mascotte comme image de départ, puis ajoutez votre audio. Assurez-vous que le personnage est le vôtre ou fictif: n'utilisez pas le personnage d'une autre entreprise ni les traits d'une personne réelle. Si le clip est une publicité, vérifiez les exigences actuelles de la plateforme où vous allez le publier.
Puis-je utiliser la voix d'une personne réelle pour l'objet?
Seulement votre propre voix, ou une voix que vous avez clairement l'autorisation d'utiliser. Vous enregistrer et joindre ce fichier est la façon la plus simple et la plus sûre d'obtenir une touche humaine. N'imitez pas une célébrité, un collègue ou qui que ce soit sans son consentement, et n'utilisez pas un objet pour prêter des mots à une personne réelle. Une voix synthétique issue d'un modèle de texte vers la voix évite complètement le problème.
Combien coûte une vidéo d'objet parlant?
Les générations se paient en crédits, et le coût dépend du modèle et des réglages choisis, donc un chiffre écrit ici serait vite périmé. Une vidéo d'objet parlant comporte quelques étapes, une image, une piste vocale et une animation, et l'étape d'animation est généralement la plus grosse. Les nouveaux comptes démarrent avec des crédits gratuits, et la page des tarifs donne les offres actuelles.
Choisissez un objet sur votre bureau et donnez-lui une réplique. Ouvrez le toolkit de Picasso IA, générez d'abord le visage et voyez s'il sait dire bonjour.